Wie viel Geld verlieren Sie, weil die gleichen IT-Probleme immer wieder auftreten, Ursachen unklar sind oder nicht rechtzeitig auf vermeidbare Probleme reagiert wird? Mit der Verbindung von Monitoring, Alerting & Ticketing steht eine effiziente Methodik zur Verfügung, die Ihre Probleme löst.
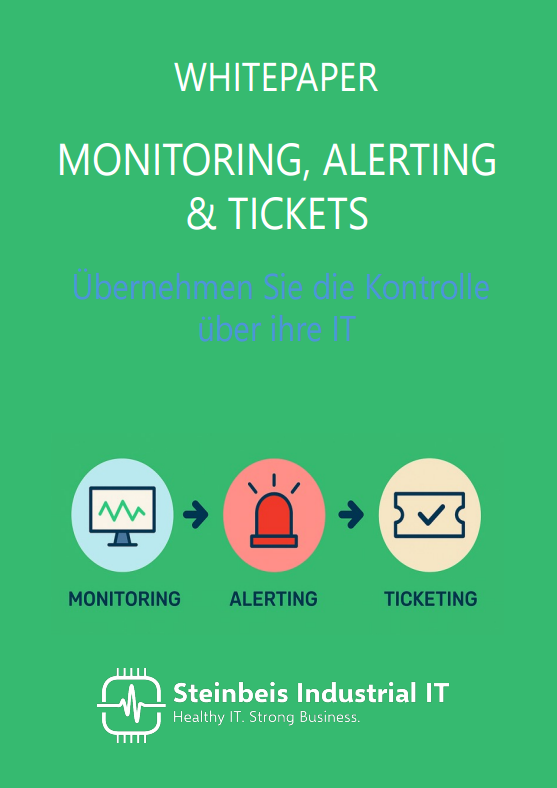
Während Monitoring die kontinuierliche Überwachung der IT darstellt, ist die Einbindung über ein Alerting-Tool das Werkzeug, um den IT-Support zu informieren, bevor das Problem passiert. Als würden Sie bei Ihrer IT regelmäßig Blutdruck messen und Ihrem Arzt das Ergebnis mitteilen, damit es falls nötig rechtzeitig behandelt werden kann. Über das angeschlossene Ticketing Tool erfolgt die professionelle Abarbeitung der Störungen und deren Dokumentation.
In der Praxis hören wir oft folgende Aussagen:
- Bei uns laufen die Server „so lange sie laufen“
- Störungen werden erst spät bemerkt oder werden per E-Mail oder Telefon an die IT gemeldet
- Die IT reagiert – aber selten proaktiv und es ist meist zu spät und ärgerlich
Genau hier helfen Monitoring, Alerting und Ticketing.
Wir beschreiben nun, wie das ganze funktioniert, aber zunächst erklären wir die Grundbegriffe:
Monitoring
Mit Monitoring Tools werden IT-Systeme, Anwendungen und Prozesse kontinuierlich überwacht. Tools wie Zabbix, PRTG oder Checkmk erfassen Kennzahlen wie CPU-Auslastung, RAM, Festplattenstatus oder Netzwerklatenz.
Alerting
Bei definierten Schwellenwerten werden Alarme ausgelöst. Diese können priorisiert (Info, Warnung, Kritisch) und über verschiedene Kanäle (E-Mail, Teams, SMS, Whatsapp) versendet werden. Wichtig dabei: die Alarme müssen sinnvoll korreliert und gefiltert werden, um eine Alarmflut zu vermeiden.
Ticketing
Aus relevanten Alarmen entstehen strukturierte Fehler-Tickets. Diese enthalten alle notwendigen Informationen zur Bearbeitung: Fehlerbeschreibung, betroffene Systeme, Priorität, Historie. Tickets ermöglichen Nachverfolgung, Eskalation und Dokumentation.
Insbesondere die Dokumentation vermeidet, dass wertvolles Unternehmenswissen beim Verlassen von Mitarbeitern verloren geht (siehe auch unser Whitepaper zum Einsatz von KI…).
Nur wenn alle drei Komponenten zusammenarbeiten, entsteht ein effektiver Störungs-Management-Prozess (im Fachjargon „Incident-Management“ genannt).
Wie die 3 Bausteine miteinander verknüpft sind, verdeutlicht die folgende Ansicht:
Ein Beispiel für Erfolg nach der Einführung dieser Prozesskette
Der IT-Dienstleister für die Betreuung der IT-Infrastruktur für mehrere ARD-Sender sowie das ZDF und beschäftigt rund 130 Mitarbeitende.
Vor der Einführung strukturierter Prozesse war die IT-Dokumentation zerstückelt: Informationen lagen verstreut in Excel-Dateien, Wikis und Word-Dokumenten. Monitoring war rudimentär, Alarme wurden manuell ausgewertet, und Tickets entstanden oft erst nach Nutzerbeschwerden.
Nach der Einführung der 3 Komponenten wurden folgende Ergebnisse erzielt:
- 90 % weniger manuelle Dokumentation durch Einführung einer Geräte- und Verwendungsdatenbank (siehe auch unser letzter LinkedIn Beitrag zum Thema Asset-Management)
- Frühzeitige Erkennung von Problemen, z. B. bei Serverausfällen oder Netzwerklatenzen
- Automatisierte Ticketverarbeitung mit klarer Zuweisung und Nachverfolgung
- Höhere Transparenz und Planbarkeit bei IT-Ressourcen und Wartungsfenstern
- Entlastung des IT-Teams, da Störungen nicht mehr reaktiv, sondern proaktiv behandelt werden
Unser Fazit: Monitoring, Alerting und Ticketing sind keine isolierten Werkzeuge
Wer die drei Komponenten sinnvoll kombiniert, schafft nicht nur Reaktionsfähigkeit – sondern echte Proaktivität, Transparenz und Effizienz im IT-Betrieb und erspart sich teilweise hohe Kosten durch Ausfälle.
Lesen Sie detaillierte Informationen in unserem Whitepaper mit einer Marktübersicht für KMU und einer pragmatischen Einführungsstrategie: